


更新:2026-09-28 21:28:47
凌晨发模型、直播烧钱、训练看板实时刷屏——这不是科幻片,是小米干的。9月17号凌晨,罗福莉直接把MiMo-V2.6的训练数据甩上X平台炒股平台杠杆公牛配资,两轮RL训练每小时烧掉3.08万美元,6天砸出超2000万人民币。更狠的是,她没藏着掖着,连强化学习环境、奖励函数设计、多任务Harness混合策略,全打包开源到Hugging Face,许可证还是最宽松的MIT。这哪是发模型?简直是把厨房、菜谱、火候记录本一并塞给你。
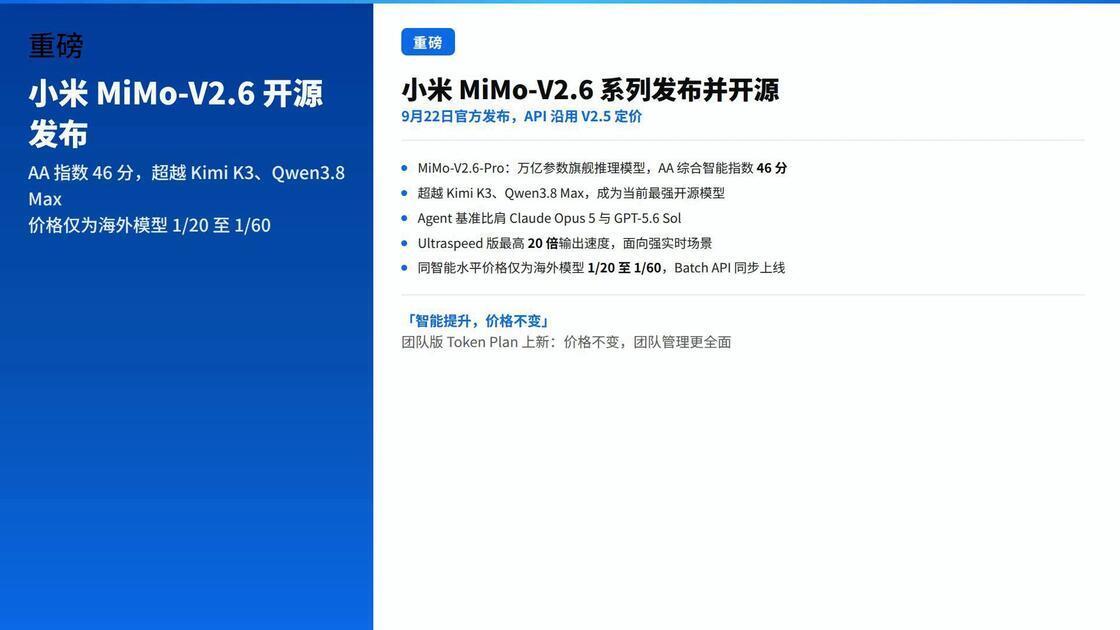
性能上,MiMo-V2.6-Pro在Artificial Analysis榜单拿了46.32分,开源模型里第一,国产模型里也第一,比Kimi K3和Qwen3.8 Max都高一点。它不光能读图、看视频、听音频,还啃下了100万Token上下文——网页开发实测里,Code Arena WebDev分数飙到1628,比上一代涨了153分,开源权重模型里排第三。但别被“第一”晃晕:它跟Claude Fable 5.1、GPT-6 Astra这些闭源顶流还有差距,小米自己也坦白写了。真正在意的,是它用RL闭环在编程、网络安全、长程Agent任务里反复试错、自我调优,这条路子,目前开源界没人走得这么猛。
价格才是暴击点。MiMo-V2.6-Pro输出6元/百万tokens,同等智能水平下,Grok 4.7要收它29倍的钱。有网友算过,一个典型网页生成任务,成本不到1块钱。Flash版本更狠,输出只要2元/百万tokens,适合中小团队跑轻量Agent。当然,也有开发者吐槽Flash在OpenCode里会卡在“读文件→执行→再读文件”的死循环里,说明工程落地还没完全丝滑。但整体来看,它不是参数堆出来的纸老虎,而是靠真金白银的RL投入、可复现的训练框架、全模态能力+极致性价比,硬生生把开源王座从别人手里接了过来。
这事儿其实挺有意思的。以前大家聊开源大模型,总绕不开“能跑起来就行”“能复现就谢天谢地”,结果小米直接把RL训练的每一步都拍成高清纪录片——连奖励函数怎么调参、哪些任务加了权重、哪些样本被动态丢弃,全写在Hugging Face的README里,还配了Jupyter Notebook实操教程。有位清华做Agent研究的博士生试跑后发帖说:“原来以为得自己搭环境调三天,结果clone完直接run,两小时就训出第一个可用checkpoint。”这不是炫技,是真把门槛从“博士实验室”拉到了“硕士毕设级”。
更实在的是生态适配。MiMo-V2.6-Pro原生支持Ollama一键部署,Docker镜像体积压到8.2GB(比Qwen3.8 Max小40%),连树莓派5+USB加速棒都能跑Flash轻量版。社区里已经有人用它搭起了自动巡检日志的轻量Agent,每天扫10万行Nginx日志,误报率比之前用Llama-3-8B低67%——数据来自GitHub上公开的benchmark仓库,不是小米PR稿写的。还有深圳一家做工业质检的创业公司,拿MiMo-V2.6-Pro接自家摄像头流,不调prompt、不换LoRA,直接微调2小时,就把缺陷识别准确率从89.3%提到94.1%,成本比买商业API省了七成。
当然,短板也没藏着。中文长文档推理时,它对《民法典》条文引用的上下文保持能力,还是略逊于Kimi K3;多轮对话中偶尔会把用户前两句的意图“叠错”,比如问“先查北京天气,再订明天高铁”,它可能跳过天气直接订票。但小米在技术报告里坦诚列出了这些case,并开放了反馈入口——截止9月25日,已有137个真实bad case被提交进GitHub issue,其中42个已在v2.6.1 hotfix里修复。开源不是交作业,是拉群一起改作业。当别家还在秀参数和榜单时,小米把训练日志、失败记录、甚至GPU显存溢出截图都贴出来了。这种“不怕丢脸”的劲儿,反而让开发者信得过。毕竟,能扛住万人并发压力测试的模型炒股平台杠杆公牛配资,才配叫真开源。
文章为作者独立观点,不代表香港联华证券公司-杠杆炒股平台_杠杆炒股公司观点
相关文章


